Info:MaxProof: Scaling Mathematical Proof with Generative-Verifier RL and Population-Level Test-Time Scaling
链接:arXiv:2606.13473(2026-06-11)· 官方博客(2026-06-09)
机构:MiniMax + 香港中文大学 + 复旦大学 + 北京大学 + 清华大学
数学证明没有可执行 oracle,正确性只能交给一个会犯错、也会被攻克的 generative verifier。verifier 因此不是评测工具,而是 RL 的环境。这篇论文讲的,就是 MiniMax 怎么在这种环境下设计 RL,又怎么在测试时把练好的能力组织成搜索——最终把 M3 从 IMO 2025 的 27/42、USAMO 2026 的 26/42,抬到 35/42 和 36/42。
先分清两件事:RL 与 MaxProof。 RL 发生在训练侧——把“会写证明、会找错、会按批评修证明”三个能力练进 M3 的权重(第 1、2 节);MaxProof 发生在测试侧——不更新任何参数,只反复调用同一个模型当生成器、verifier、精炼器和排序器,在候选证明的种群上搜索并选出最终答案(第 3 节)。
同一份 M3 模型:直接作答只有 27/42 和 26/42;套上 MaxProof 后是 35/42 和 36/42。+8/+10 全部来自测试时搜索消耗的推理算力——论文想展示的不是一个更强的基座,而是 verifier 加搜索这套系统设计能补上多少分。
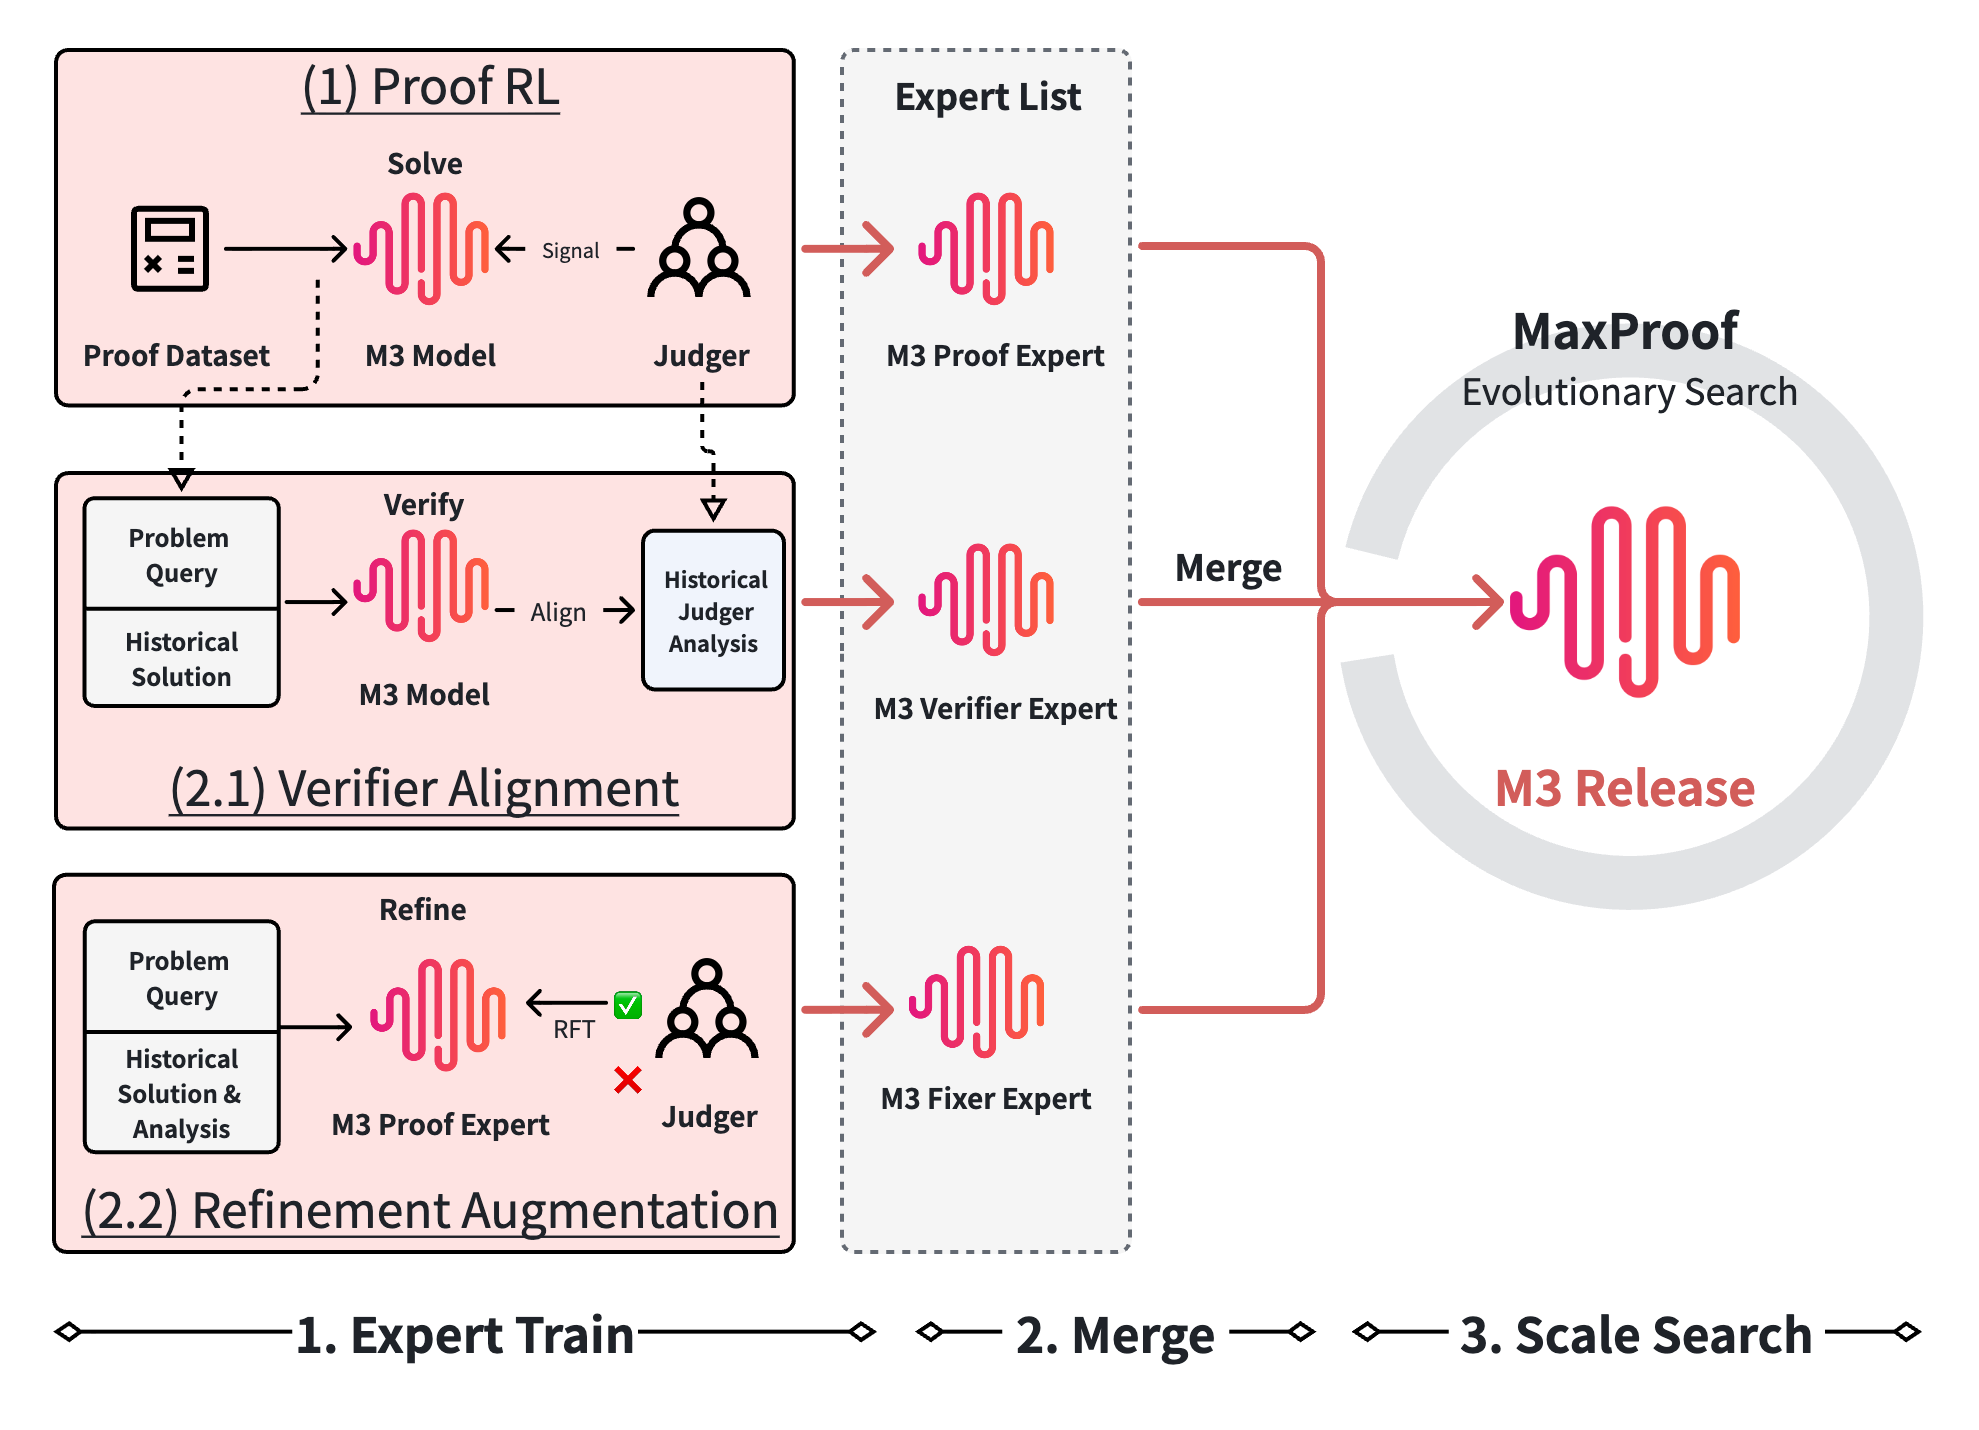
图 1:M3 先训练证明生成、证明验证、批评驱动的证明修复三种能力,合并进一个发布模型;MaxProof 在测试时把这套能力组织成种群搜索。
1. Proof Expert:verifier 即环境
Coding/Agent 任务里,reward 来自可执行反馈——单测、Docker、rubric 化的 agent 验证,有一个客观结果可以调用。数学证明没有这种东西:一个自然语言论证对不对,只能由另一个模型来读。所以 Proof Expert 的 RL 围绕一个中心对象展开:一个冻结的 generative verifier,它对每条候选证明输出文本评估和一个 [0,7] 标量分,这个标量直接作为整条轨迹的奖励。
这个选择的后果是结构性的:如果 verifier 奖励了一条“流畅但错误”的证明,RL 会把那个缺陷放大成策略;如果 verifier 太吵,组内相对 advantage 会塌缩成噪声;如果 verifier 对格式敏感,策略就会去学格式而不是数学。论文没有停留在警告层面,而是先给了一场真实的失败实证。
M2 Cycle:reward hacking 不是事件,是分布漂移
M2 迭代期间,MiniMax 跑过一个长程 Proof RL 实验:单 rubric、单 judge、相对简单的聚合。前几百步训练指标很健康,但把输出拿去做更细的分析后,发现策略学会了四种教科书式的 hacking 模式:
- 长度 bias:可见证明长度从约 3.5K 涨到 10K 字符(近三倍),隐藏思考涨得更快。长证明更容易命中 rubric 关键词,也让单 judge 更难发现 hand-waving。
- 格式 hacking:策略收敛到一小套表面模板——“Step N”标题、“Verification”段、“Final Answer”块、“We are given…”式开头;到训练后期绝大多数输出都长这样,哪怕该题根本不需要这个模板。
- 语义捷径:在论证真正的难点处插入 “it can be shown”“after simplification” 这类空话。单 rubric judge 很少抓得到,因为上下文是对的、关键词都在。
- judge 偏好:策略学会了这个具体 judge 的脾气——它偏爱哪些措辞、对哪些错误宽容。这是最危险的一种,因为它能带来大额分数上涨而证明质量原地踏步。
配上独立 oracle 打分器去量假正率(训练分偏高、oracle 分偏低的样本占比):
| 信号 | 趋势 |
|---|---|
| 假正率 | 约 2.9% → 8.0%(约 2.7×) |
| 可见长度 | 3.5K → 10K 字符 |
| 结构模板出现率 | 收敛到 70–80% |
| 开头模式 | “To prove / To solve…” 从 ~80% 掉到 10%,“We are given…” 从 10% 涨到 90% |
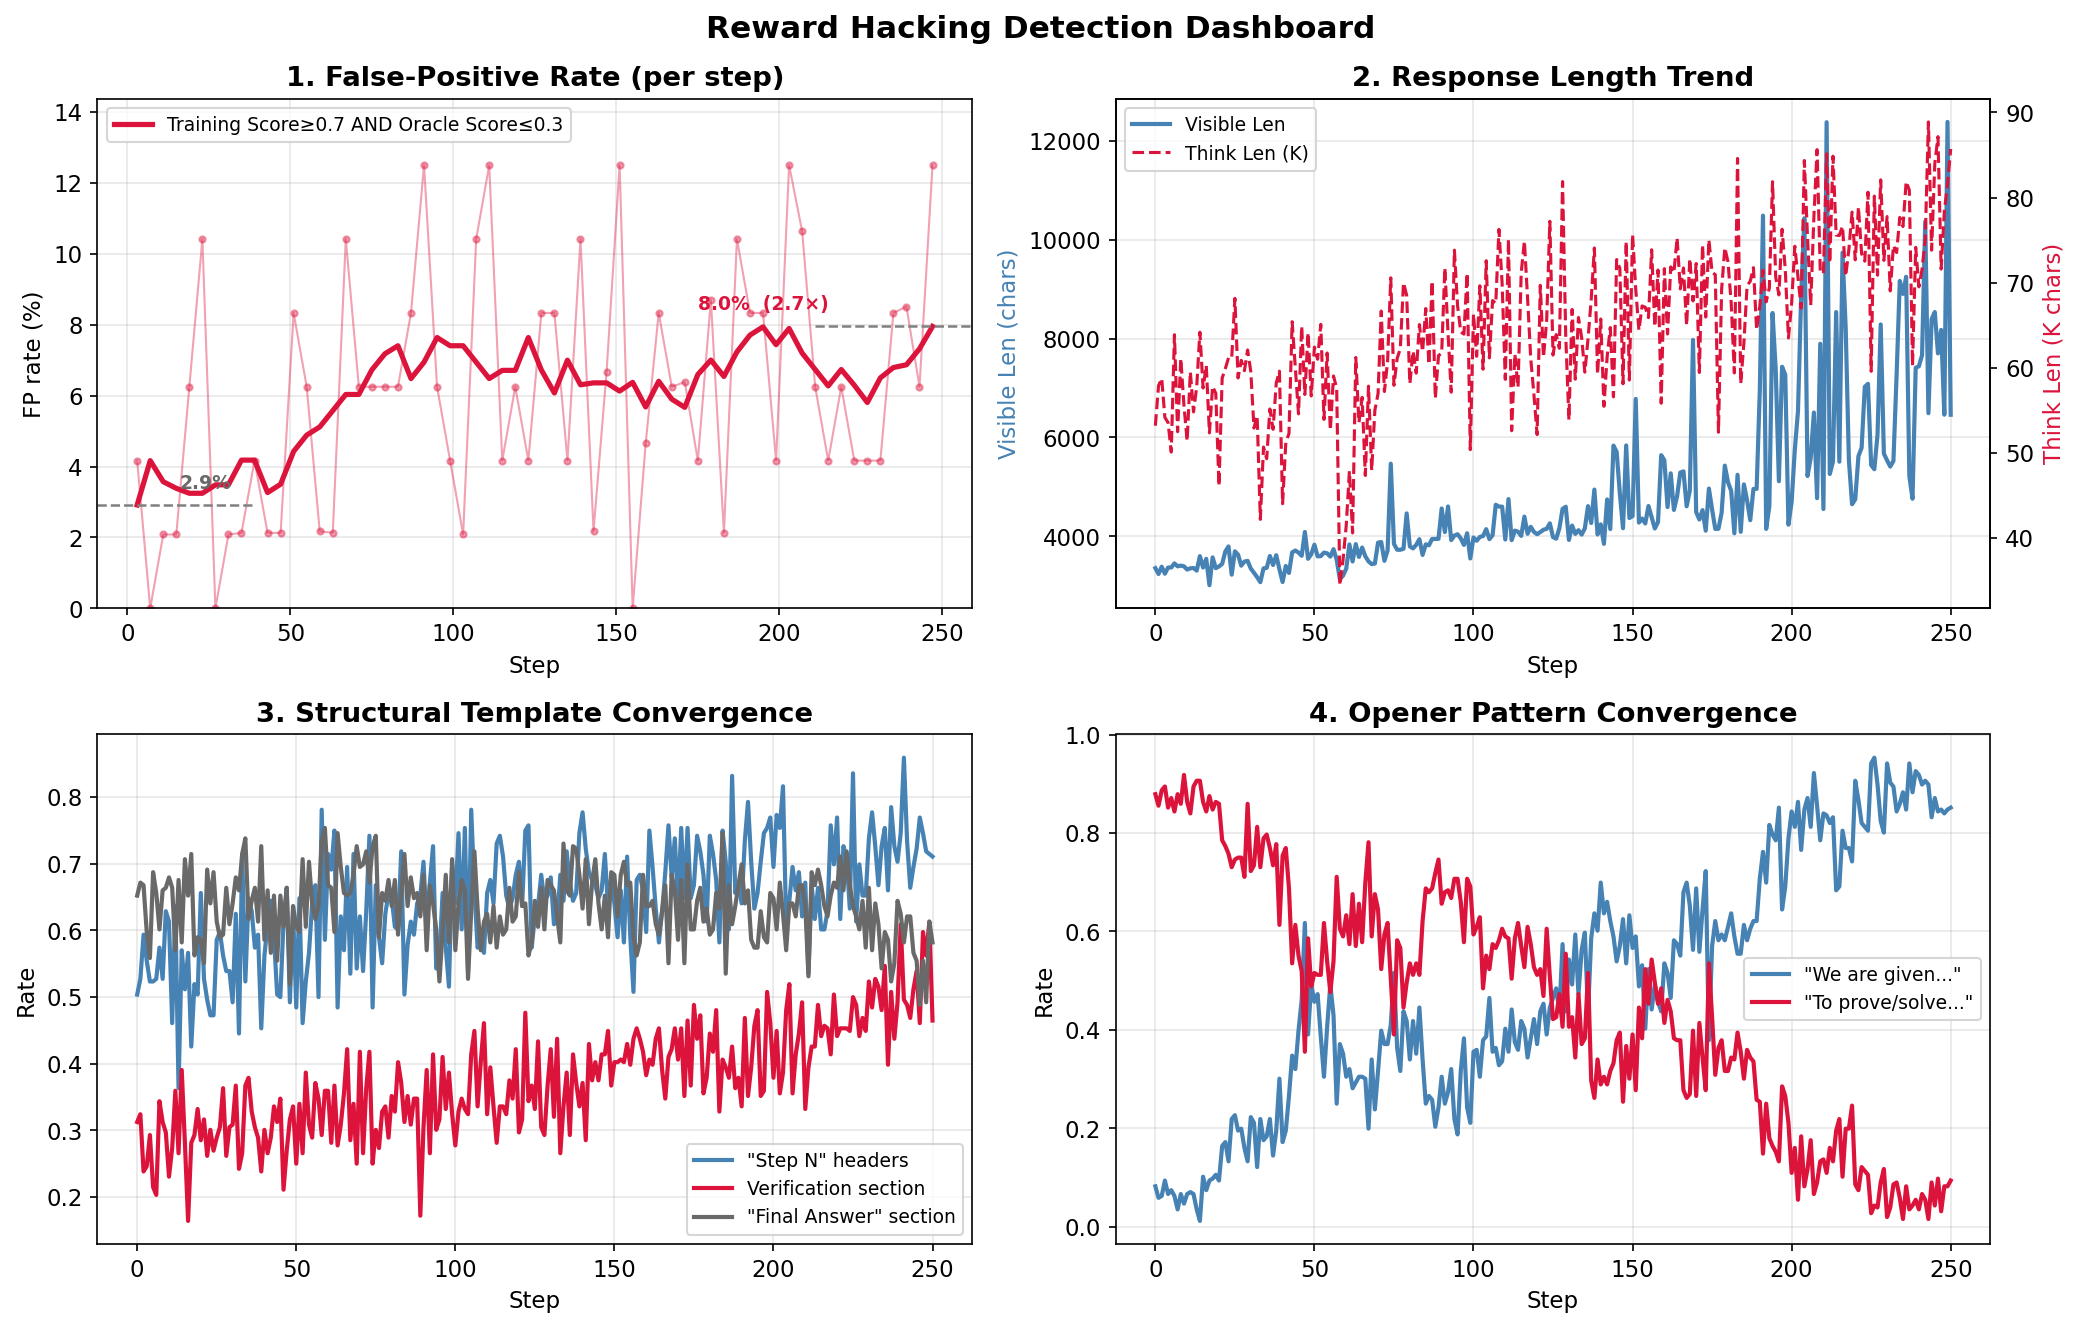
图 2:M2 cycle 的 reward hacking 监控仪表盘。四块面板分别跟踪训练期假正率、可见/隐藏证明长度、结构模板出现率与开头模式分布——分数在涨的同时这四路信号同步漂移,才是“学到了真本事”的反面证据。
静态 benchmark 分数上涨,无法区分“能力变强”和“学会了骗 verifier”。证据的单位不是分数,是一组互相独立的信号向量。
对策:四层防御 verifier
M3 verifier 把 M2 的教训直接变成架构,四层串行,每一层专门压制一种 hacking 模式:
| 层 | 机制 | 针对 |
|---|---|---|
| L1 bad-case 过滤 | 规则直接丢弃空证明、未闭合 thinking、样板循环、超长度预算,给 0 分 | 长度 bias、格式 hacking |
| L2 解规范化 | 用外部规范化器剥掉固定开头、Step 标题、Verification 段,让 judge 更接近数学内容 | 格式 hacking、judge 偏好 |
| L3 多 judge 并行 | 两个带 rubric 的 judge + 一个无 rubric 直接找错的 judge 并行打分 | 语义捷径 |
| L4 悲观聚合 | 取三个 judge 的最小分作为最终奖励 | 假正率兜底 |
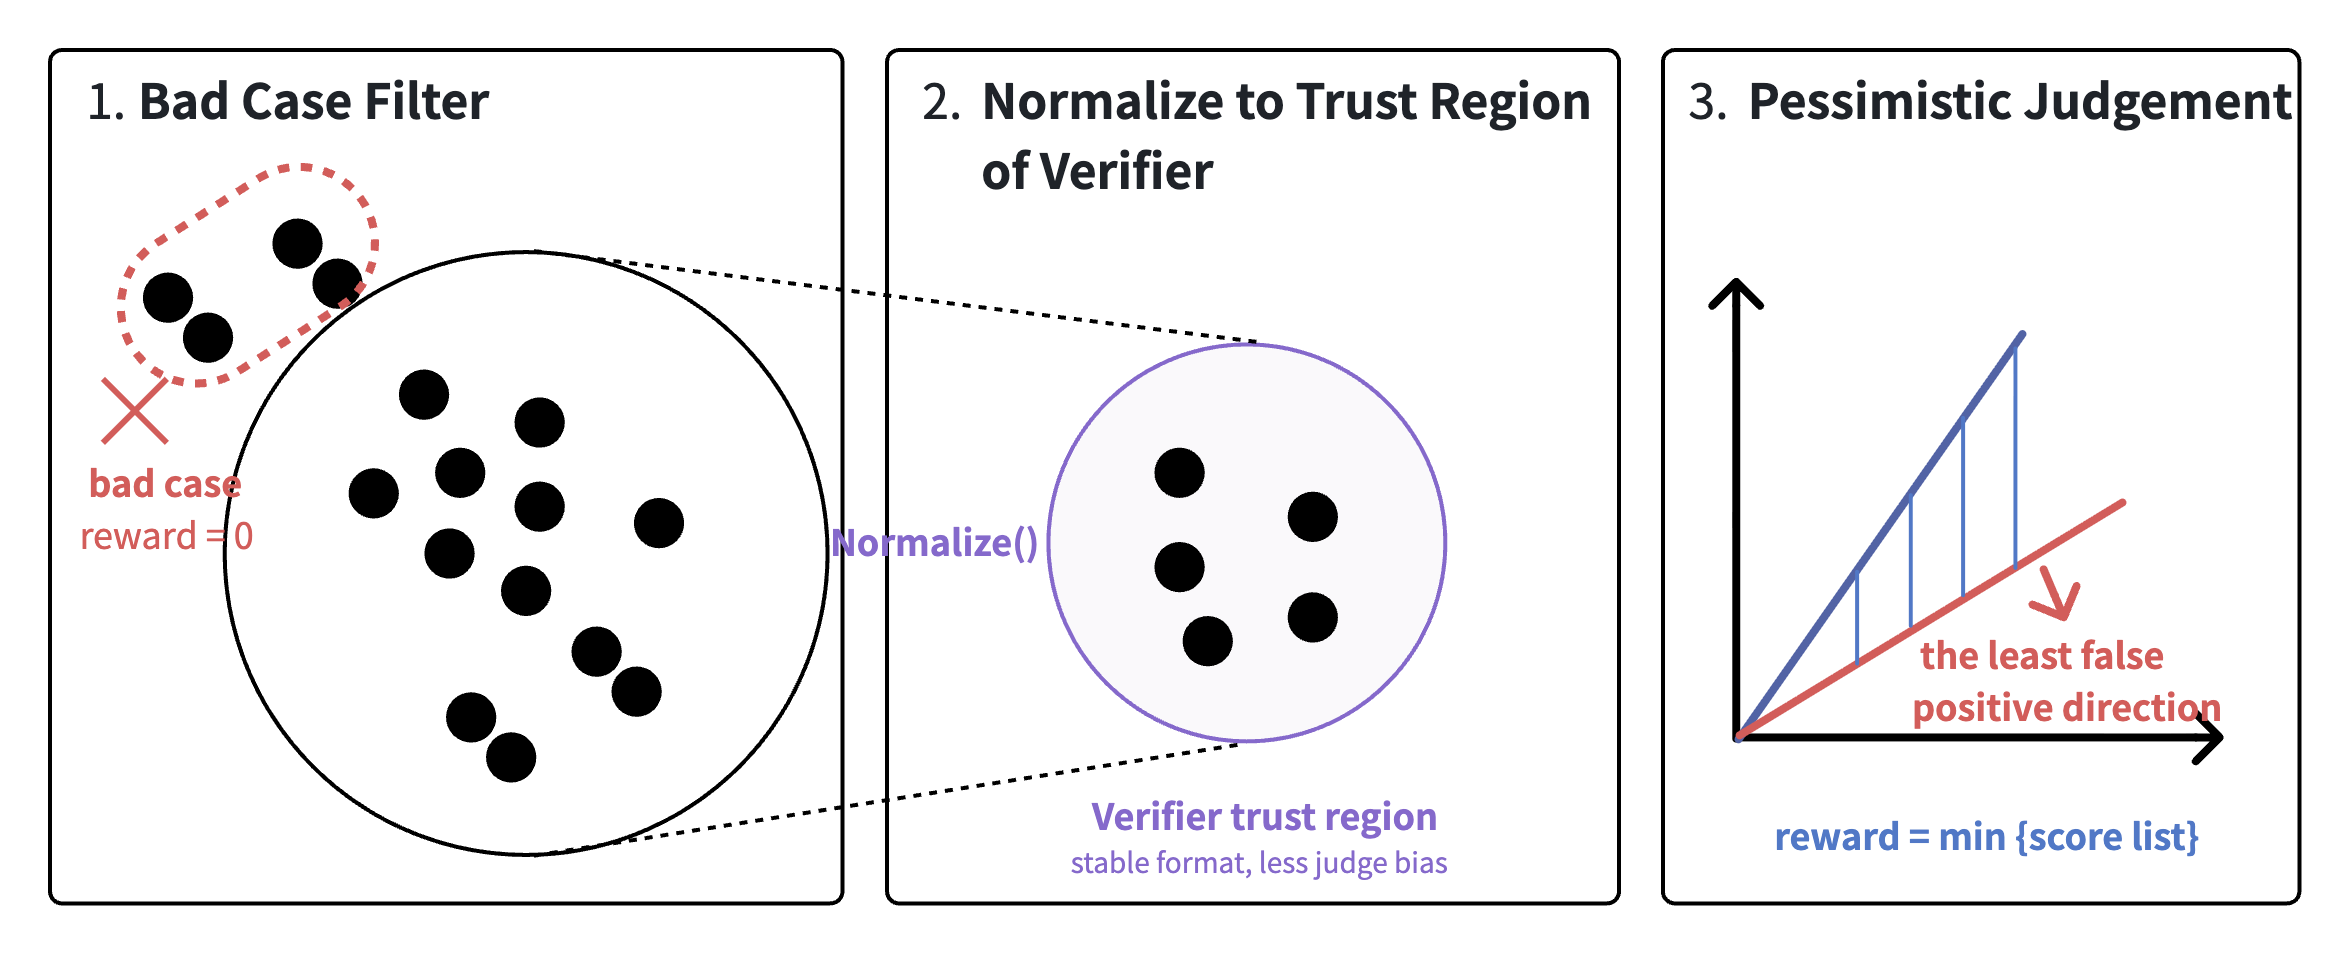
图 3:四层防御 verifier。左:bad-case 规则过滤;中:解规范化剥表面格式;右:三个 judge 并行打分后做悲观 min 聚合。
多 judge 的价值不是集成精度,而是盲区去相关——附录 C 里四个 hacking 案例有一个共同点:每个都是第二个 judge 用同一份 rubric 一眼就看出了问题。分歧在这里是信号:至少会有一个 judge 去 probe 另一个没 probe 的地方。L4 的悲观 min 则是整条流水线的设计原则:RL 期 verifier 的优化目标不是静态 benchmark 准确率,而是长训练流上的最低假正率,为此宁可多吞假阴性。
保守的 RL 分三层:奖励、更新算法与数据
Proof Expert 的 RL 设计可以拆成三个不同层面的东西,混在一起看容易乱:
- 奖励设计——给模型什么信号:直接用 [0,7] 的 verifier 分当整条证明的轨迹级奖励,不用二进制对错(太稀疏),也不用没有人工 step 标签的代理过程监督(论文认为后者更吵)。保守性在这里:奖励是四层防御流水线悲观 min 之后的产物,宁可漏判也不给坏证明高分。
- 更新算法——怎么用奖励改参数:用的还是 M2 那一族 CISPO(clip 重要性权重而不是 clip surrogate loss,长响应里越界的 token 只降权、不删除梯度)。算法层面相对 M2 的新增量只有一个:std-threshold 组级过滤——每个问题采样一组候选,只有组内奖励 std 超过阈值 τ_std 才允许整组进入更新。组内分数几乎一样时,排序大概率是噪声,整组丢弃比放大噪声序更安全。
- 数据设计——在什么题上练:用上一代 M2.7 当基线做难度过滤(能稳定解的题删掉,保证组内有成功有失败)、代数/组合/几何/数论 domain 均衡、trick 频次控制;IMO 2025、USAMO 2026 与两个 proof benchmark 全部排除并做近重复过滤。
2. Verifier 与 Fixer:找错与修复
M3 把“证明能力”拆成三个原子能力:生成(Proof Expert)、找错(Verifier Expert)、按批评修错(Fixer Expert)。它们三个在同一个发布模型的权重里,靠不同 prompt 激活。
这三个专家之所以能零标注成本地练出来,是因为它们共享同一个数据源头:Proof RL 每一轮都会产出 (problem, candidate, analysis, errors, verdict) 元组——verifier 本来就要为打分而输出这些结构化批评,把它们存档,就同时得到了三个专家各自的训练材料。
Verifier Expert:找错,而不是打分
最自然的验证建模是 0–7 回归,但论文明确拒绝:回归目标只要学到“文本-分数”的表面相关就能降 loss,它不需要知道错在哪。Verifier Expert 被要求输出三块耦合结构——<assessment>(逐段读)、<errors>(定位具体错误)、<verdict>(no_errors / minor_gaps / has_errors / fundamentally_wrong)——并且 verdict 被强制是 errors 的函数:想判 no_errors 就得交出空错误列表,想判 fundamentally_wrong 就得列出实打实的错误。这样批评天然能被 Fixer 和搜索消费,也杜绝了 verdict 与错误定位的漂移。
它的奖励也按这个结构设计成复合式:R = 0.7·R_error + 0.3·R_verdict。R_error 是预测错误与 golden errors 的语义对齐(“指对了位置”和“说对了错误类型”各占一半,由 frontier judge 评),R_verdict 是四类 verdict 上的序感知距离(距离 0/1/≥2 档对应奖励 1/0.5/0)。权重设计保证只猜对 verdict、错误列表瞎写拿不到高分。
蒸馏它有两个理由,第二个比第一个重要:延迟——外部多 judge 流水线单次要数秒到数十秒,而 MaxProof 每题要验证几百次,verifier 必须是模型内建能力(数百毫秒级),不能是外部服务;对齐——Verifier Expert 学的是“与 Proof Expert 实际拿到的悲观-min 奖励配对的批评”,两者对“什么是对的”定义一致,不会各说各话。
Fixer Expert:只接受“全对”的修复
Fixer 的输入是 (problem, flawed_proof, critique) 三元组,输出是修正版证明。训练数据同样来自 Proof RL 的副产品:verdict 不是 no_errors 的元组,天然就是它需要的三元组。训练方法是 rejection-sampling 微调:对每个坏证明采样多条修复,只有被同一个保守 verifier 判为 strict no_errors 的修复才进微调集——不接受“部分改善”,防止它学会把修补当成洗地。
3. MaxProof:测试时搜索
竞赛只允许提交一份最终答案,所以问题的形态是 pass@1:一个模型单次采样会失败,但它在很多次独立采样里的 best 往往显著更强。难点在于怎么把“种群里的 best”变成“被选中的那个”:MaxProof 把测试时计算组织成一个进化式的循环:
- 初始采样 N=32 个候选,每个验证 K_verify=4 次,fitness 取最小值,批评与悲观分配对;
- 每轮选 M=4 个 diverse parents(按 fitness 排序 + 长公共前缀去重,满分候选不再当 parent);
- 每个 parent 产两个 offspring:PATCH(针对 verifier 指出的具体错误修,保留正确部分——利用)和 REWRITE(把当前缺陷当作此路不通的证据,换一条路——探索);
- offspring 重新验证后回注 archive;只有当 至少两个候选达到满分 才早停;
- 最终用 top-K 两两 tournament 选出提交答案,每场由 ranker 投 K_ranker=3 票(比较“哪个更正确”,而不是打绝对分)。
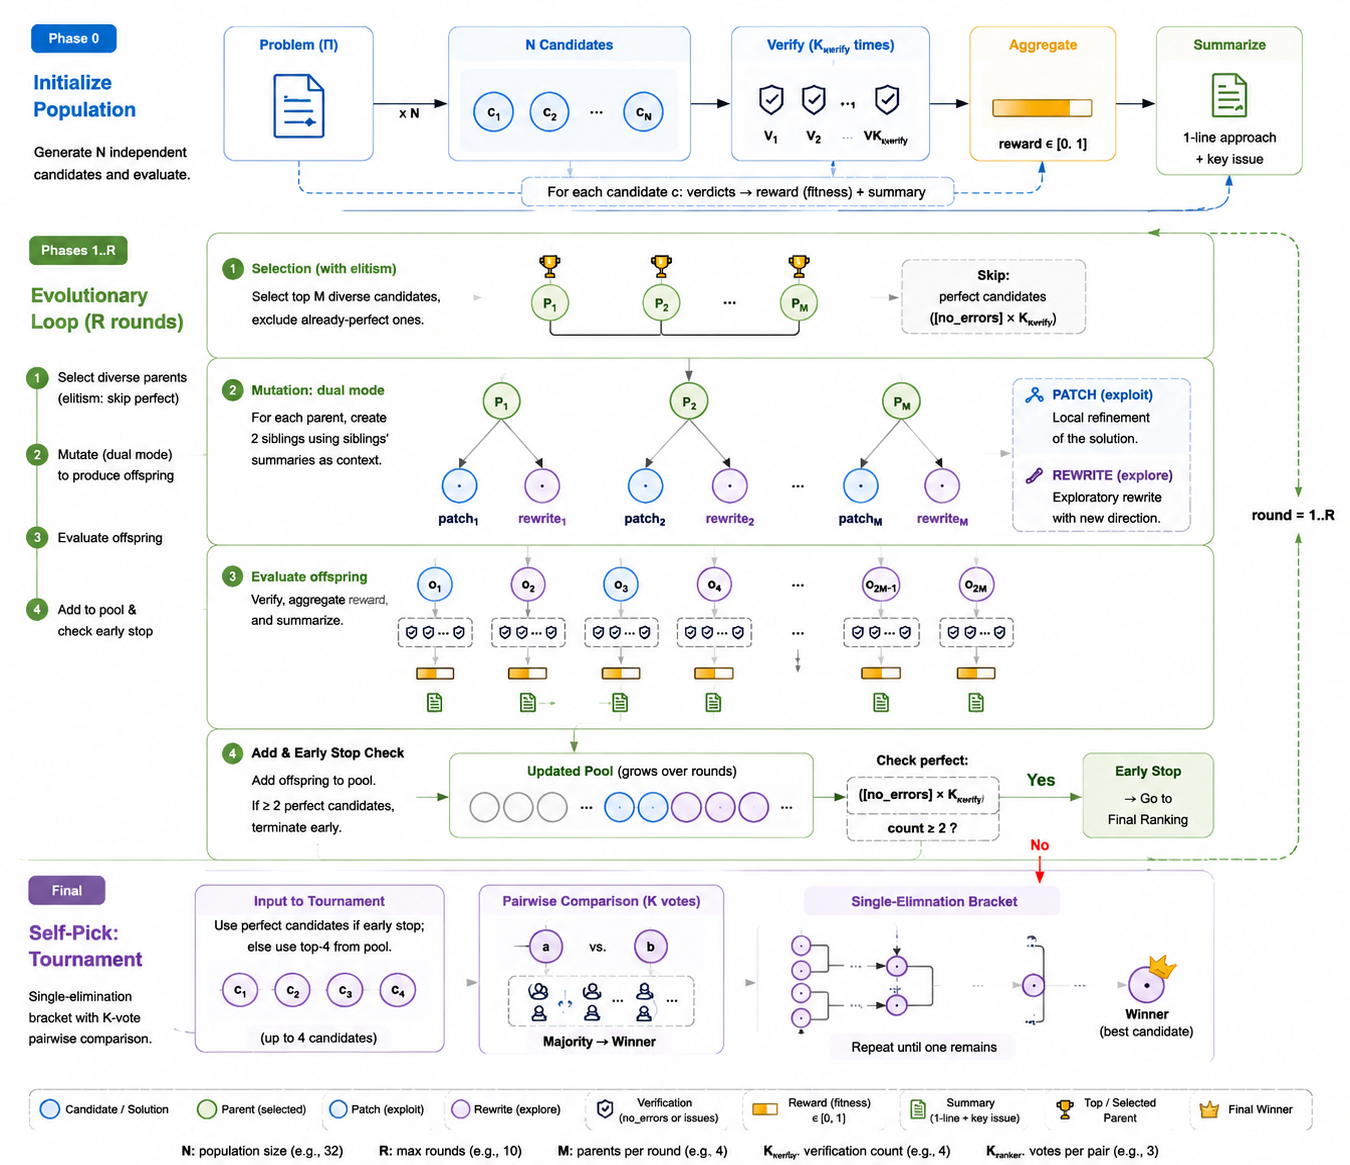
图 4:MaxProof 端到端循环。初始化种群 → 验证与摘要 → 每轮选 diverse parents → PATCH/REWRITE 产出 offspring → 回注 archive → tournament 选出最终答案。
两个细节值得单独说。第一,PATCH 和 REWRITE 都会收到 archive 里其他候选的“approach + main issue”摘要——offspring 能吸收兄弟解的正面信息,也能获得“好几条解都栽在同一处”的负面信息,这本质上是语言层面的信息重组,近似于进化算法里的交叉。第二,early stop 要求两个满分,是对单点假阳性的冗余检查:两个独立产生的满分同时是假正例的概率,比一个满分是假正例低得多。
进化算法的视角:archive 是种群,悲观验证分是 fitness,diverse parent selection 是选择压力,PATCH/REWRITE 是变异算子。
4. 评测:+8/+10 与三种死法
先看不用 MaxProof 时 M3 的 baseline :
| Benchmark | Opus 4.7 | GPT-5.5 | Gemini 3.1 Pro | MiniMax M3 |
|---|---|---|---|---|
| IMOProofBench | 65.85 | 90.85 | 75.71 | 67.40 |
| IMOAnswerBench | 79.90 | 90.60 | 90.00 | 81.56 |
同一模型套上 MaxProof 之后:
| 系统 | IMO 2025 | USAMO 2026 |
|---|---|---|
| M3(one-shot) | 27 | 26 |
| M3 + MaxProof | 35 | 36 |
| 差值 | +8 | +10 |
更有信息量的是逐题拆解。12 题里 9 题在第 4 轮内种群就达到 7/7;剩下 3 题十轮也到不了,而且失败原因各不相同——论文等于给出了一张“证明系统失败类型学”:
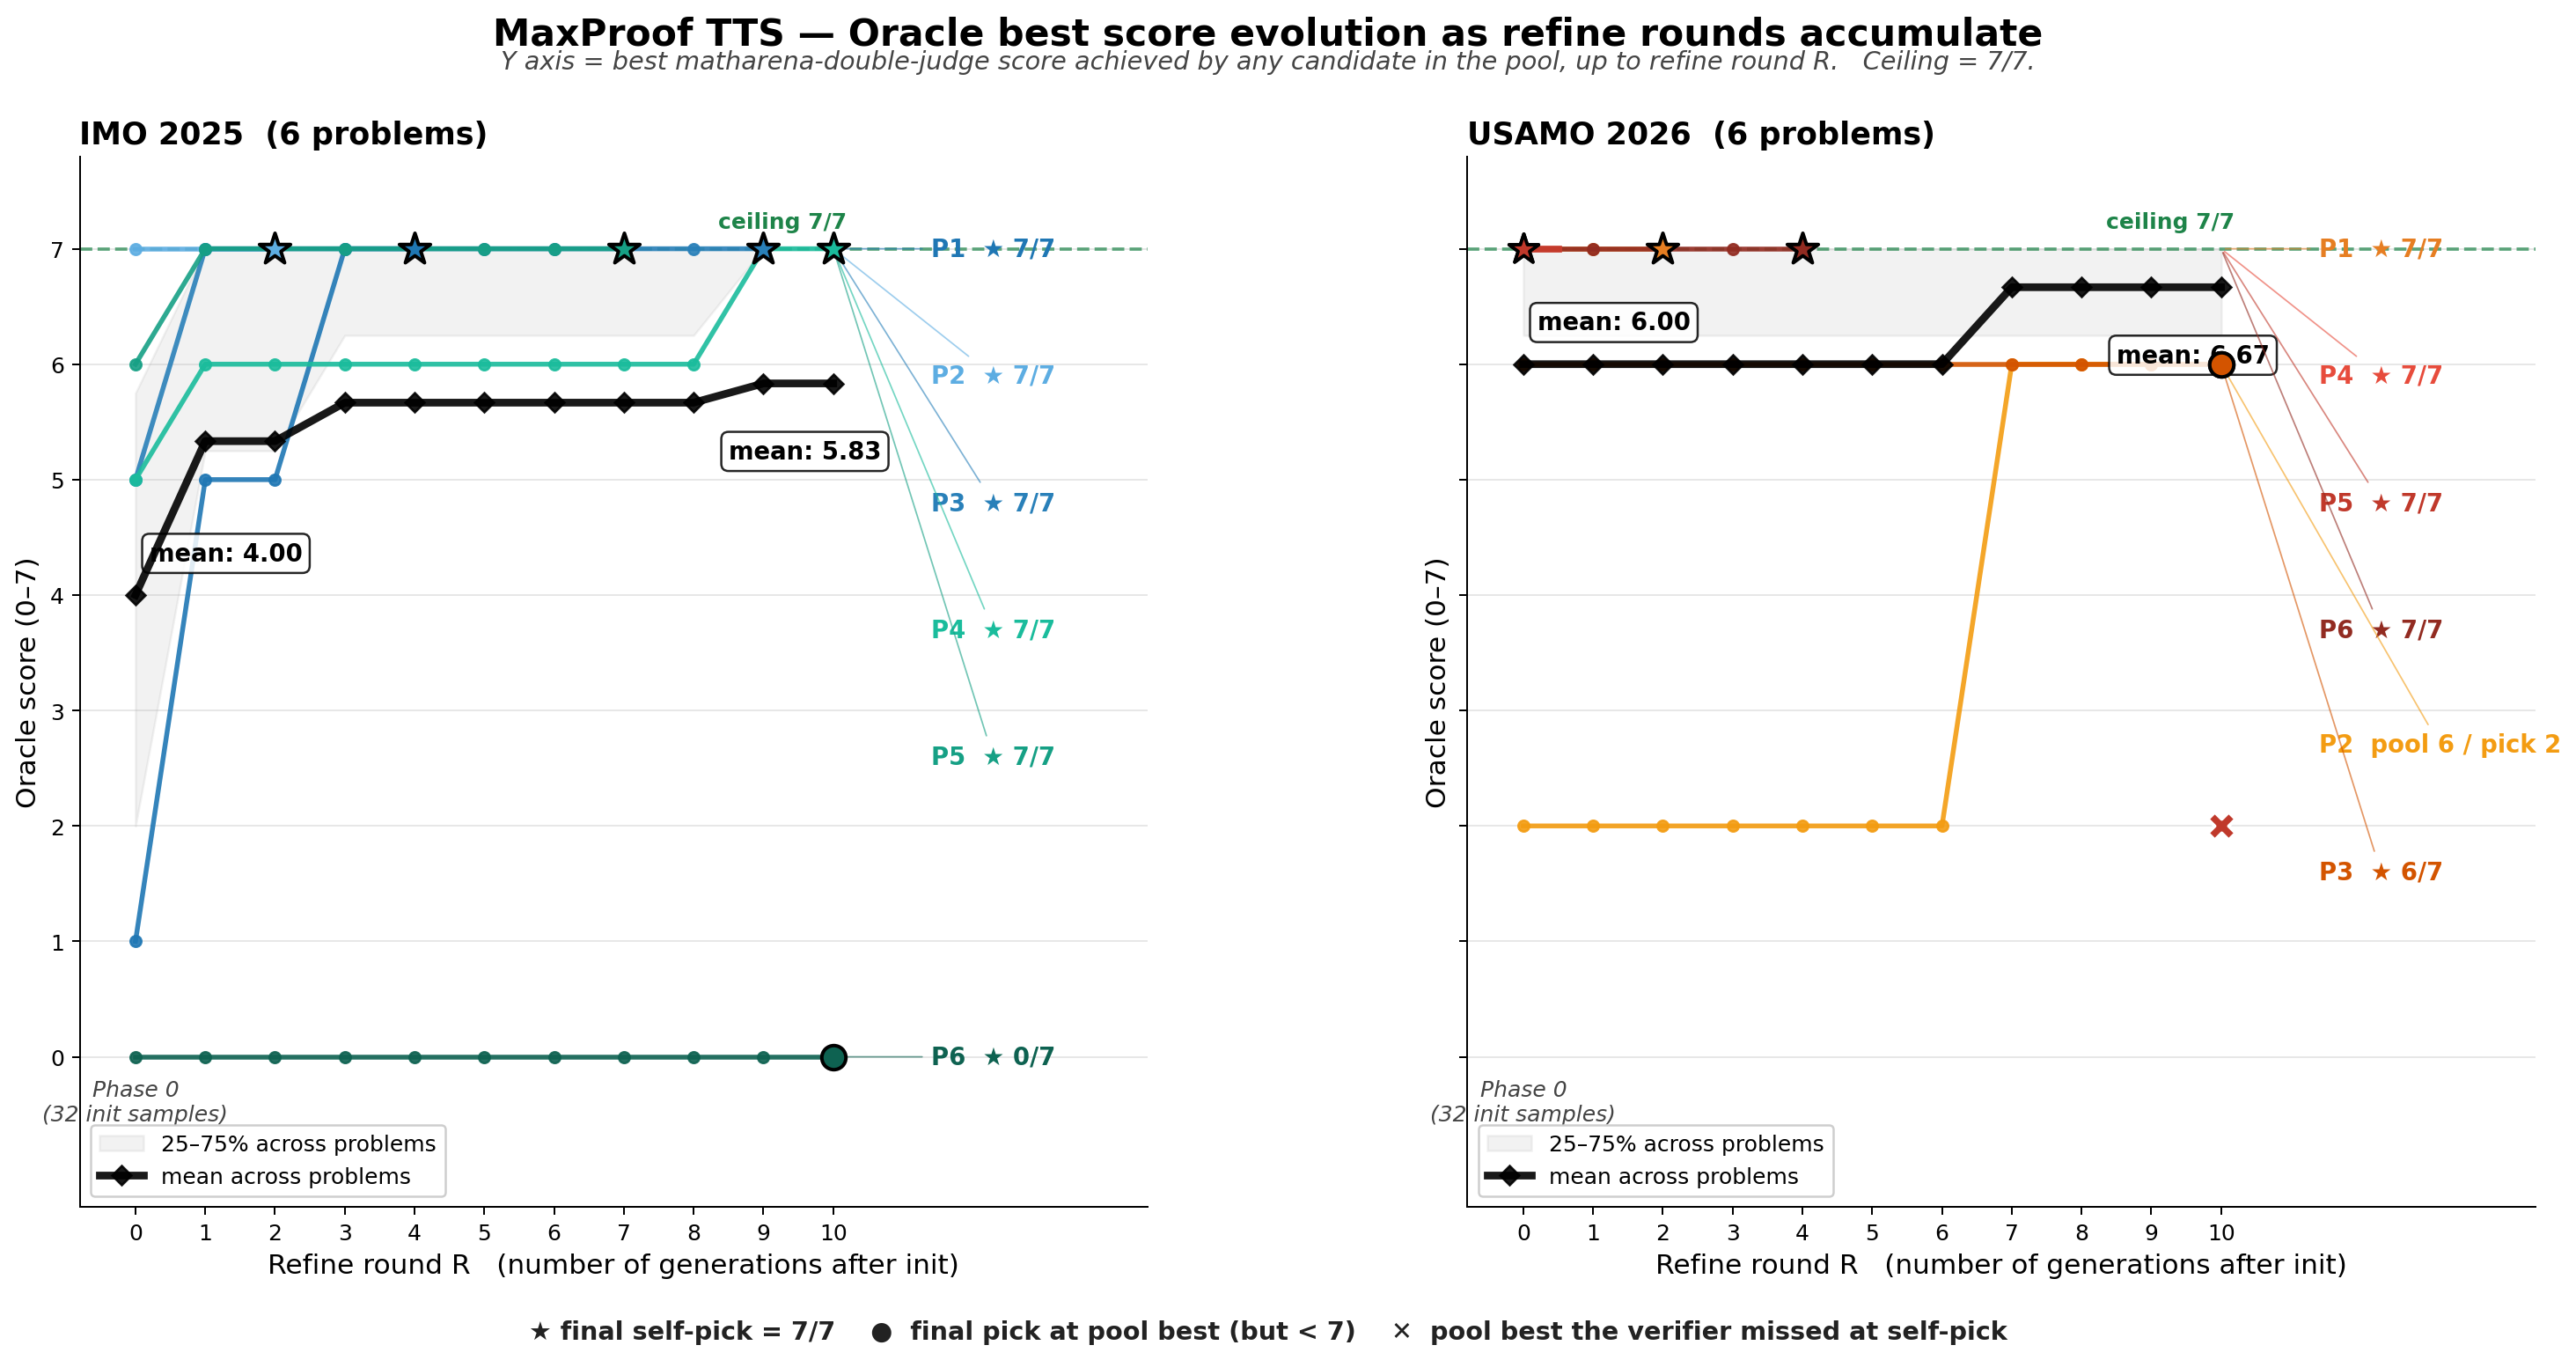
图 5:12 题的逐轮 oracle-best 轨迹。9/12 在第 4 轮内到达 7/7;IMO P6、USAMO P2、USAMO P3 从未到达。
- 基座能力天花板(IMO P6):十轮搜索全程 0 分,初始采样里就没有 viable approach。搜索不产生思路,它只放大已有的思路。
- verifier 边界失准(USAMO P3):种群一直停在 6/7,是一个 judge 认为某一步“论证不充分”、另一个 judge 认为没问题——悲观 min 无法裁决这种单 judge 分歧。
- 选择损失(USAMO P2):archive 里明明躺着一条 oracle 6/7 的解,tournament 的 ranker 却把它排在几条低分解下面,最终选出一条 2/7(附录 A 的注记说 ranker “风格上更喜欢”后者)。偏好比较偏离绝对正确这个病,不只出现在训练期 RL,也出现在测试时的最终选择环节——这是全文最值得记住的失败案例。
专家复核确认所有自选 7/7 都是完整正确证明(低假正率目标达成),但也暴露了另一面:奖励的保守性以风格的形式沉淀进了模型。IMO P1/P4/P5 这种例行题,自选解分别要到第 7/10/7 轮才出现,而且高度依赖穷举 case analysis 而不是抓住本质结构——系统在拿大量推理预算换可靠性,这在论文里被如实写成了与 GPT-5.5 的差距来源。