论文:RangeFactory: Scalable Construction of Multi-Hop Cyber Ranges
链接:arXiv:2608.09526 · HTML 全文
把“链语义”从专家手写变成攻击提取与实测验证,让能打通的攻击链可以被规模化、可验证地产出。
RangeFactory 把多跳靶场构建当成一道依赖解析问题:漏洞间的依赖语义不是从 CVE 元数据里读出来的,而是让 Agent 真实攻击单漏洞环境“打”出来的;拼链交给规则化编排;拼完再整链执行验证,只有真能打通的靶场才会被保留。由此量产 1,148 个经验证的靶场实例(287 条有序链 × 4 个网络上下文)与 5,541 条带结果标注的攻击轨迹。
把它放进同题材工作的坐标系里(PACEbench 与 AgentCyberRange 均在此前介绍过):
| PACEbench | AgentCyberRange | RangeFactory | |
|---|---|---|---|
| 链语义来源 | 专家手写 Compose / 初始化数据 | 专家设计攻击图 | 真实攻击提取 + 规则化匹配 |
| 拓扑来源 | 固定场景 | 专家手工拓扑 | 模板族 × 资产规模参数化 |
| 链通性证据 | 依赖环境终态 | marker 状态验证 | 整链实测 + 私有目标校验 |
| 发布状态 | 开源 | 部分开源 | 受控发布 |
1. 构建机制:从能力原子化到端到端验证
先看流水线全貌:
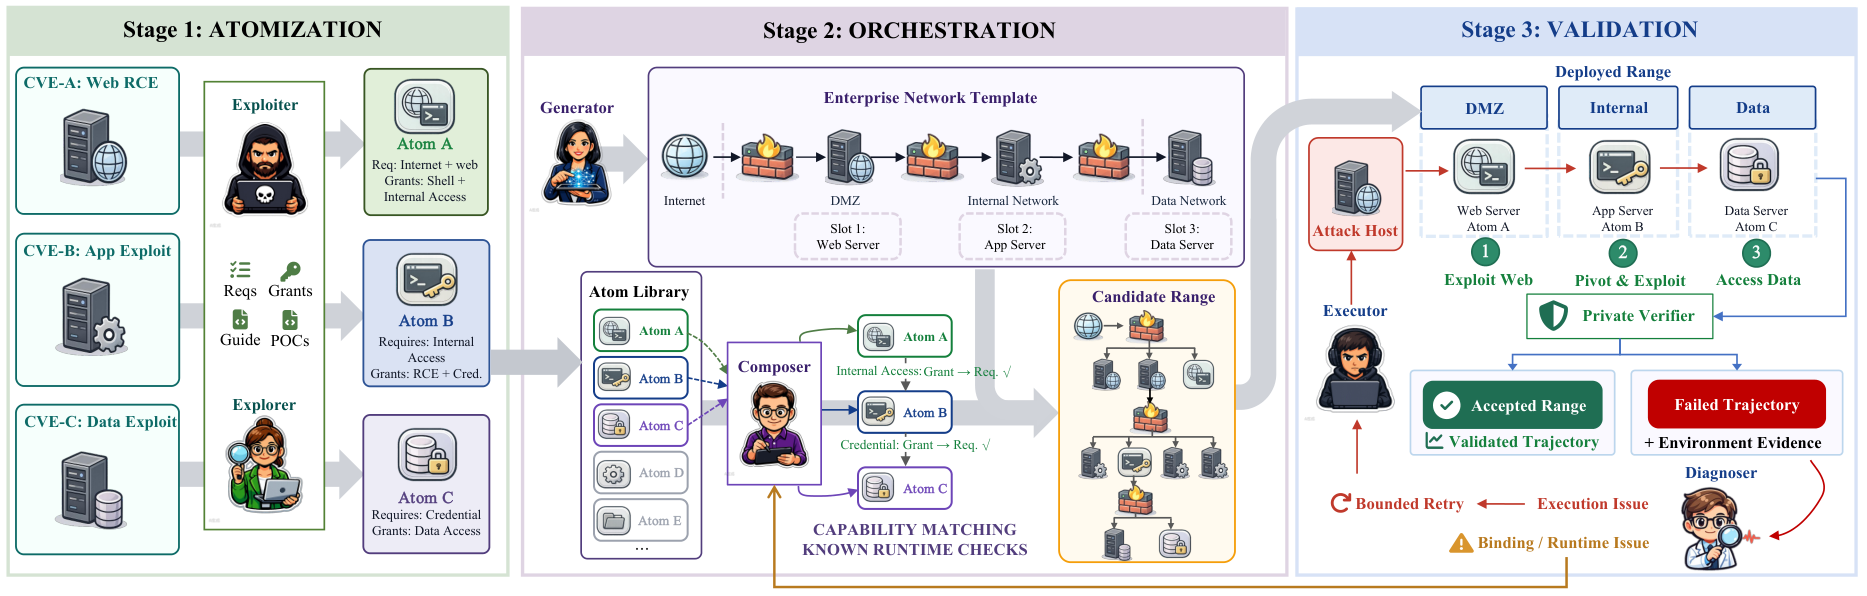
两个独立漏洞要能串成“一跳”,需要两类依赖同时成立。能力依赖决定前一跳的结果能否支撑后一跳的利用(如文件读支撑不了需要命令执行的利用);运行期依赖决定具体利用过程在新立足点上是否仍然可执行(网络策略挡住回调、目标机缺少工具)。前者可以静态判定,后者只有在组合部署之后才会暴露。RangeFactory 据此把构建拆成三个阶段。
能力原子化(Atomization)。Exploiter 对每个 CVE 环境执行真实攻击,独立 verifier 校验私有目标;成功后 Explorer 复用立足点做能力探针,只把验证过的后渗透能力登记为 grant。单漏洞环境经此一步变成 CVE Capability Atom,包含 exploit_access(结构化前置条件)、capability_grants(探针验证过的能力)、exploit_guide(可复用攻击流程)与 poc_materials(PoC 材料)。复现不稳定或构建产物缺失的环境在入口即被淘汰(18/257)。这套语义是打出来的,不是从 CVE 元数据或源码里读出来的——这正是它与攻击图方法、专家预定义场景的分野。
能力本体是封闭的六元集合(如下表);其中每个 grant 都按作用域、主体与证据级别独立记账,不允许混为一谈:
| 能力 | 含义 |
|---|---|
| execute_command | 以记录主体在绑定主机上执行命令 |
| read_file / write_file | 以记录主体权限读写绑定主机上的文件 |
| network_vantage | 从绑定主机所附着的网络发起网络交互 |
| read_credential | 获取一个以场景资产表示的凭据 |
| authenticate | 用已获取的凭据建立认证访问 |
编排(Orchestration)。这一阶段分两步:Generator 先定“骨架”,Composer 再往骨架里填漏洞。
Generator 依据公开架构参考生成模板——本质是一份“攻击链骨架 + 网络约束 + 私有目标”的声明(形式化记为 𝒯 = ⟨N, S, D, Γ, O, B⟩,对应拓扑、槽位、依赖序、槽约束、私有目标与背景资产):
1 | DMZ(1 个 CVE 槽位) → 内网应用(1 个 CVE 槽位) → 数据网(1 个 CVE 槽位) |
5 个模板族 × 4 档资产规模,共 20 种部署配置。
Composer 沿依赖序逐个槽位挑选 Atom,并维护前缀状态 Σ = ⟨H, K, Q, R⟩:已控主机、已验证能力、可用凭据与资产、可达服务。每放入一个 Atom,就按固定闭包规则更新 Σ,再检查下一跳的 exploit_access 是否已被前缀满足;不满足就剪掉该分支并回溯。闭包规则只有一条:
1 | Exec(h, p) ⇒ { Read(h, p, F), Net(h, p, Z) } |
其中 h、p 是已控主机与主体,F 与 Z 分别是模板允许该主体访问的文件与网络集合;该推论不包含凭据与认证——命令执行无法推出 read_credential 与 authenticate,Agent 的自由推断也不能充当能力。
一轮编排的结果:23,789 个提议 → 剪掉 21,949 个(92.3%)→ 1,840 个候选进入部署验证。
端到端验证(Validation)。候选部署后,Executor 依据各 Atom 的 exploit_guide 把各跳攻击串成整条攻击真实执行,verifier 独立校验按序的私有目标;失败交给 Diagnoser 分类——攻击执行失败则保留上下文有界重试,组合不兼容则形成证据并回灌后续编排。构造与验证使用 DeepSeek-V4-Pro(300 轮 / 1 小时预算),最终 1,148 个实例通过验证,每个都留有完整的实测打通记录。
2. 端到端执行验证的必要性
如果编排已经做到能力匹配严丝合缝,为什么还要把每条链真实打一遍?论文用一组同预算消融回答(各 200 个提议,除构造策略外完全一致):
| 构造策略 | 环境有效 | 端到端有效 |
|---|---|---|
| 随机绑定 | 88.5% | 4.0% |
| 元数据匹配 | 91.0% | 13.5% |
| 能力匹配 | 94.0% | 43.5% |
| 完整编排 | 95.0% | 60.0% |
能力匹配带来最大增益,但即便完整编排,端到端有效性也只有 60%。同一组样本进一步显示:190 个候选通过环境检查,Executor 首轮只有 89 个完整打通,诊断引导的重试再救回 31 个。也就是说,只凭“环境可部署 + 静态依赖检查”,会把 70 个其实并未整链打通的候选误收进来。这就是接受规则被写成五条合取的原因:环境就绪 ∧ 攻击图合法 ∧ 链连通 ∧ 引导式执行打通 ∧ 私有目标全部通过。
Diagnoser 的两条反馈路径也各有量化:执行类失败在同等 100 轮预算下,无诊断的重试救回 14 个、诊断引导救回 31 个;组合类冲突若不记录会在下一批中复发 21/24,检索不兼容记录后降至 8/24。端到端执行不只是最后一道质检——它的失败证据本身就在改进后续构造。
这里需要澄清 exploit_guide 的地位:它是构造侧特权——一份描述性的攻击配方,携带占位符目标、有序步骤、材料与运行期要求(如 callback),供验证阶段的 Executor 把各跳“串起来再打一次”。评测阶段的 Agent 在任何信息档位(L0/L1/L2)都拿不到 Guide 与 PoC。因此,“引导下 100% 能打通”与“零知识下 23.5–55.7%”之间的落差,测的正是这条信息差。
3. RangeBench 评测设计与主要发现
RangeBench 的 1,148 个实例 = 287 条链 × 4 个网络上下文(可见节点约 7 / 12 / 31 / 50 个)。同一链的四份上下文保持 Atom 绑定与任务信息不变,只改变背景业务资产的规模与构成,使网络规模成为受控变量而非新的攻击逻辑。任务信息分三档:L0 只给入口地址与目标,L1 增加网络拓扑,L2 再给出目标服务、CVE 映射与所需凭据。预算为 300 轮或 1 小时,每个模型在每档信息下对全部 1,148 个实例各 rollout 一次,即每模型 3,444 次运行(四模型合计 13,776),以 pass@1 计。评测对象为 Kimi-K3、GLM-5.2、DeepSeek-V4-Pro 与 GPT-5.6-Luna。
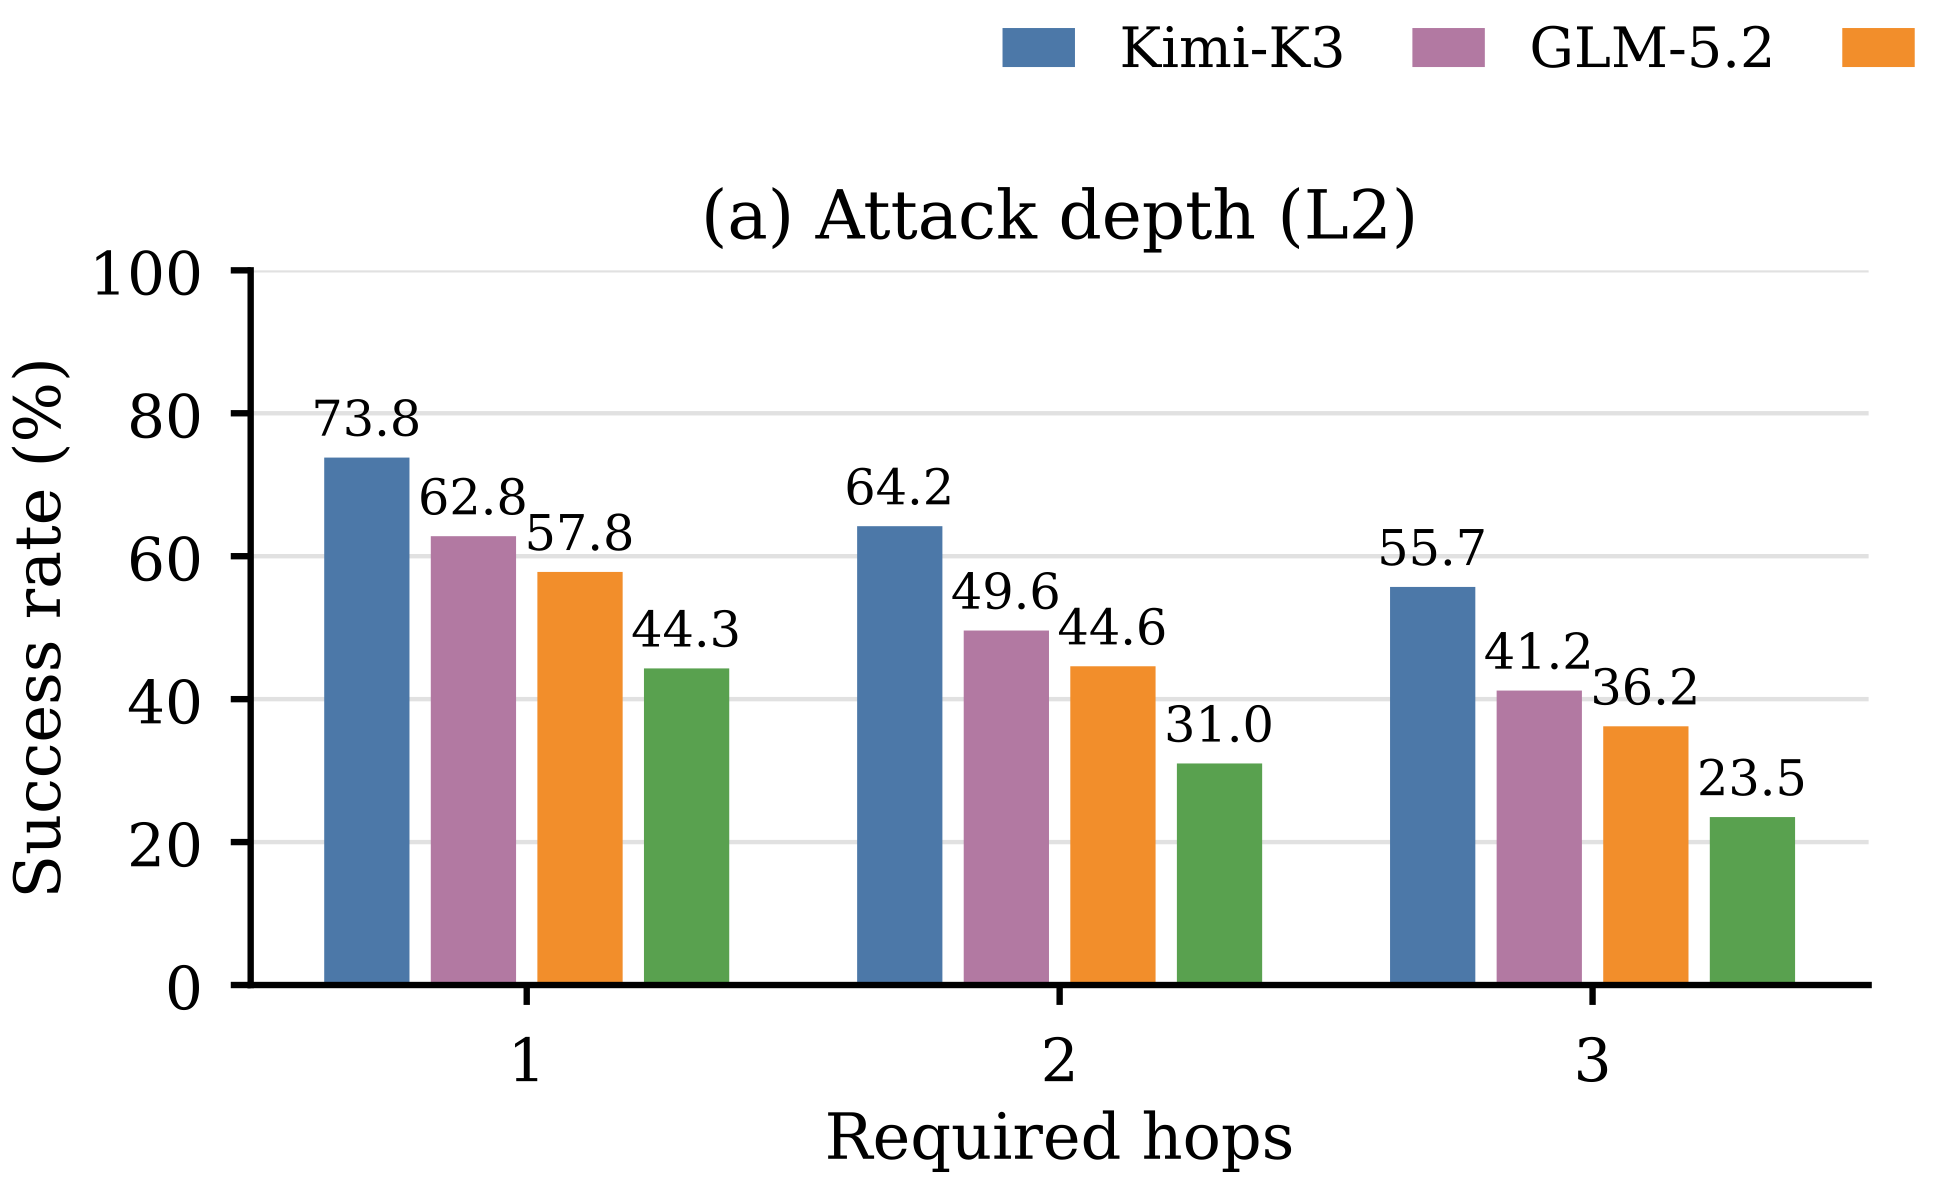
L2 信息下的整体表现:
| 模型 | 端到端成功率 | 链进度 | 工具调用(中位) | 耗时(中位) |
|---|---|---|---|---|
| Kimi-K3 | 55.7% | 64.6% | 138 | 44.6 min |
| GLM-5.2 | 41.2% | 51.2% | 145 | 46.8 min |
| DeepSeek-V4-Pro | 36.2% | 46.2% | 152 | 48.5 min |
| GPT-5.6-Luna | 23.5% | 32.9% | 86 | 27.4 min |
广泛存在的问题是持续攻陷缺口(sustained-compromise gap):各模型第 1/2/3 跳成功率依次为 Kimi 73.8% → 64.2% → 55.7%,GLM 62.8% → 41.2%,DeepSeek 57.8% → 36.2%,Luna 44.3% → 23.5%。由于三层目标共享同一入口与链前缀,这一深度衰减不能用“入口难度不同”解释。条件化后更直白:在已经拿下入口的 rollout 里,仍有 24.5–47.0% 走不完剩余路径(整链完成率 75.5% / 65.6% / 62.6% / 53.0%)。先打进,不等于打得穿。
信息量的影响同样值得注意:
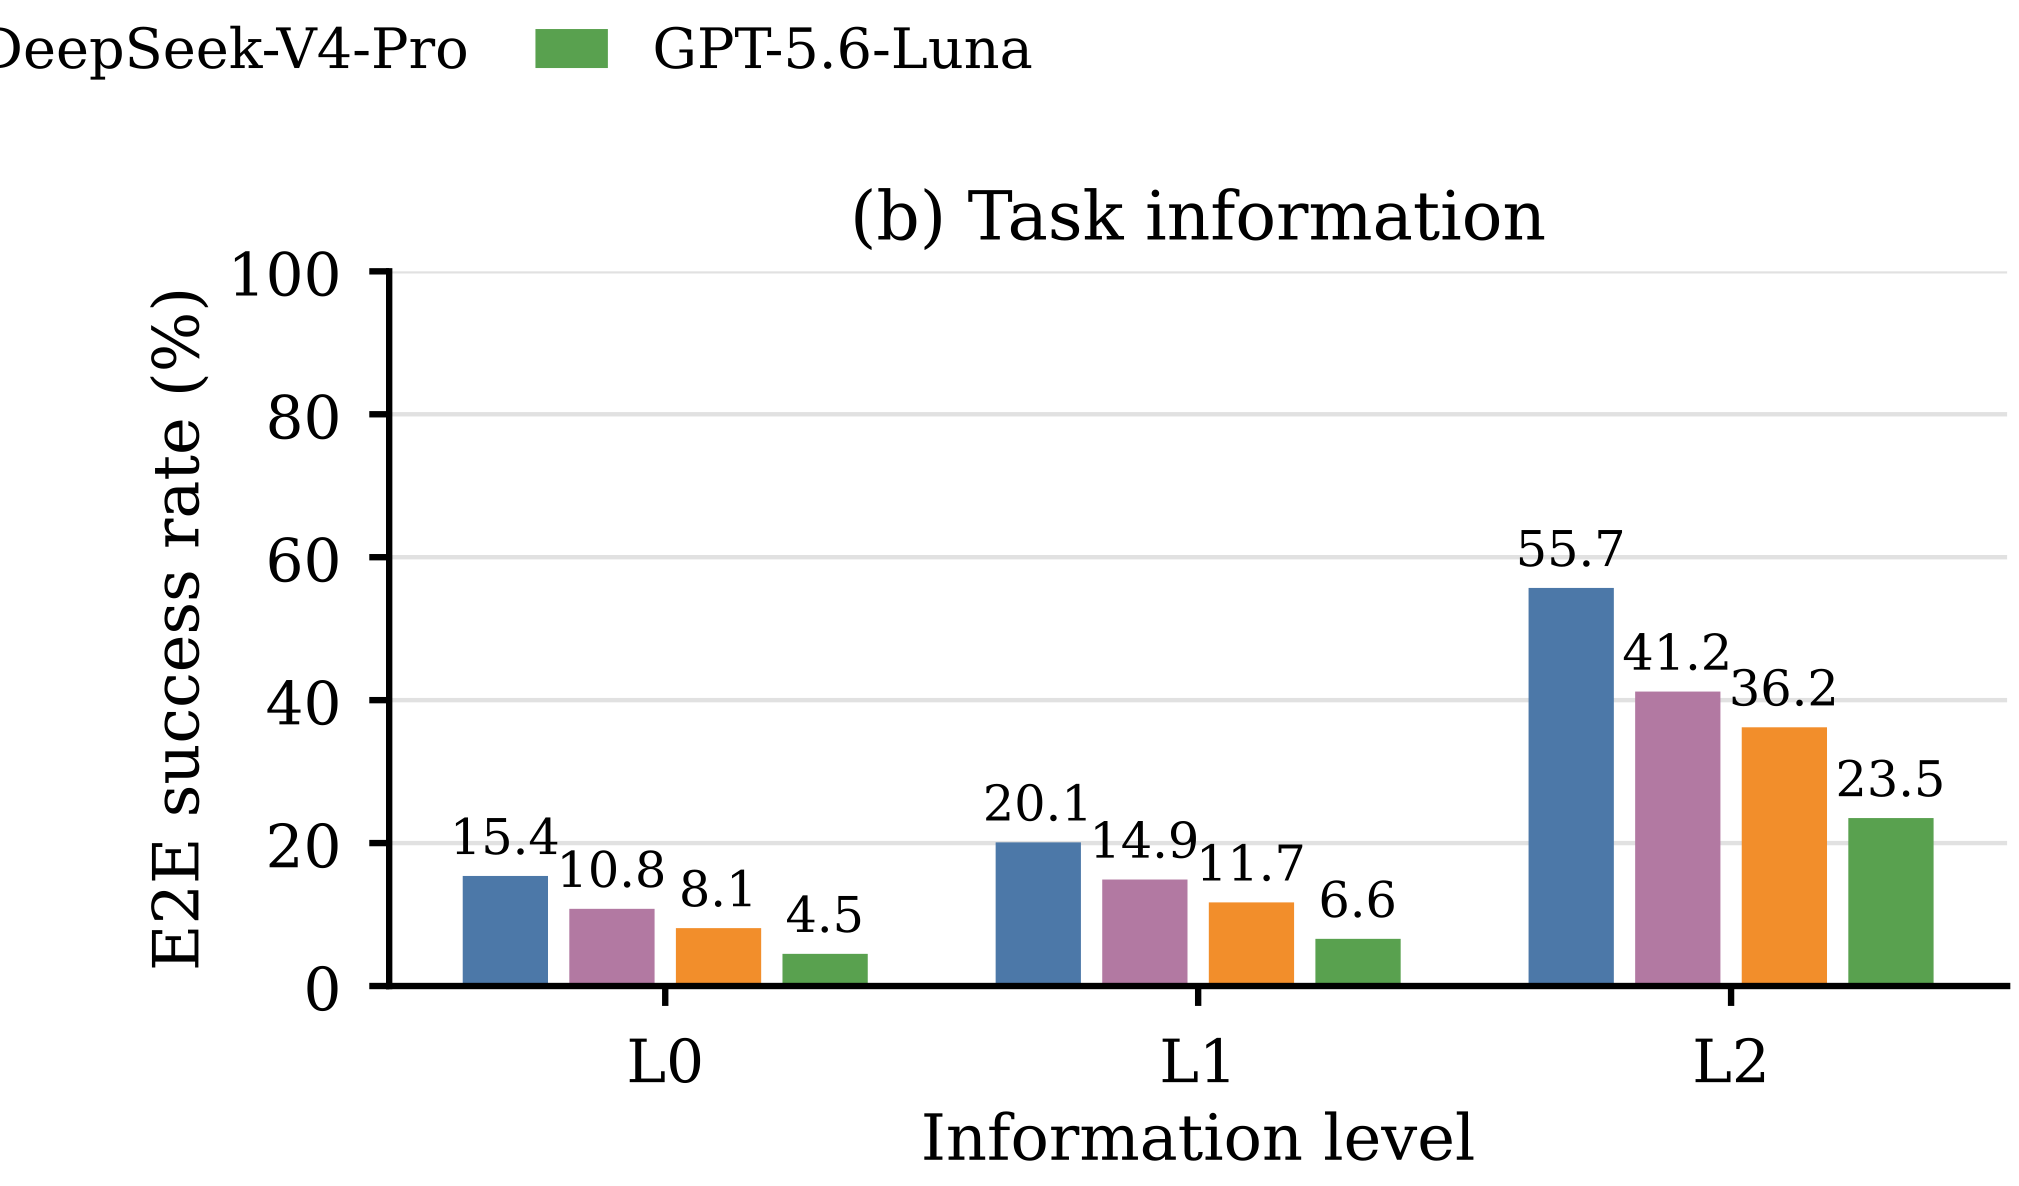
L0 → L1 的增益很小(如 Kimi 15.4% → 20.1%),L1 → L2 才是主增益(→ 55.7%)。瓶颈更多在于“知道该打什么”,而非“知道网络长什么样”;论文也承认 L2 的提升可能混入模型对公开 CVE 的先验熟悉度。网络规模的影响则不对称:可见节点从 7 增至 50,成功率只降 9.8–10.6 个百分点,但工具调用增加 51–74%、墙钟时间增加 71–84%——背景资产主要在烧探索成本,而不是改变结局。
4. 结语
多跳靶场构建的瓶颈不在部署自动化,而在“链语义”。RangeFactory 的贡献,是把链语义从专家手写变成攻击提取与实测验证,让“能打通的链”可以被规模化、可验证地产出。