1. 论文信息
论文:Capable yet Parsimonious: Extracting and Characterizing Hidden Chain-of-Thought in Frontier Models
链接:arXiv:2609.26637
机构:Aalborg University Copenhagen(Department of Computer Science / Department of Electronic Systems)+ Seafill
时间:2026-09-22
评测:MATH(80 道竞赛数学题 = 47 道 APEX Shortlist + 33 道 2026 年 2 月 HMMT)、LiveCodeBench(100 道代码题)、HLE(100 道跨学科题)
关掉 thinking、把 effort 调到最低,关掉的只是推理的默认出口,不是推理本身。注册一个什么都不干的工具并强制首次调用,推理就改道流进了可见的工具参数——换的是通道,不是能力。
2. 协议:把 tool call 当成推理工作区
工具定义本身平淡无奇(Appendix B),一个自由文本参数,描述只有一句话:
1 | { |
协议就是这个循环,论文原样给了伪代码:
1 | messages = [system, user] |
flowchart LR
    A["messages = [system, user]
reasoning effort = none"] --> B["chat(tools, tool_choice='forced-reasoning')"]
    B --> C{"response 里有 tool call?"}
    C -->|"有"| D["记录 arguments['reasoning']
回 tool_result: Received"]
    D --> E["chat(tools, tool_choice='auto')"]
    E --> C
    C -->|"没有"| F["返回 visible_text"]
三个细节决定了它成不成立:
- 只有第一次调用是强制的。 首次请求把 tool_choice 设为 forced-reasoning,保证模型第一轮一定选中这个工具,之后立刻切回 auto。被强制的只是“打开一扇门”,门后写什么、写多长,全部是模型自发的。
- 工具不做任何计算。 它没有外部副作用,唯一作用是让中间文本变成可见的 tool arguments,并通过 tool result 回灌进上下文,让模型可以跨轮次接着写。
- tool result 是空确认。 固定回一个表示“收到”的空确认,不往对话里塞实质内容,避免污染后续推理。
接下来是全文最有说服力的一组实验。作者在 GPT-5.6-Sol 上把原生推理全程关掉,对比“直接要求模型把推理写出来”和“挂一个强制工具”两种做法:
| MATH | 准确率 (%) | tokens | HLE | 准确率 (%) | tokens |
|---|---|---|---|---|---|
| no-tool: Default | 25.0 | 442 | no-tool: Default | 10.0 | 126 |
| no-tool: Plain | 36.3 | 906 | no-tool: Plain | 12.0 | 263 |
| no-tool: Maximal | 36.3 | 670 | no-tool: Maximal | 12.0 | 169 |
| Native: Low | 78.8 | 1,599 | Native: Low | 27.0 | 819 |
| Native: Medium | 92.5 | 3,403 | Native: Medium | 27.0 | 1,791 |
| Native: High | 97.5 | 5,526 | Native: High | 25.0 | 3,293 |
| Tool: Forced Default | 81.3 | 1,940 | Tool: Forced Default | 15.0 | 460 |
| Tool: Forced Maximal | 91.3 | 3,481 | Tool: Forced Maximal | 23.0 | 2,106 |
关键在最后两行:把“请写出完整推理”这类文案从 system prompt 挪进 tool description,效果是断崖式的。 更值得注意的是作者对输出内容的观察——不挂工具时,模型的输出是被整理成 Markdown 的结构化解题答案,不是推理本身;挂上工具之后,拿到的才是带试探、自我修正、省略号的 CoT 式文本。
也就是说,这个 trick 利用的不是“模型不会写推理”,而是工具参数是一个被允许的输出通道。同样的内容要求,写在 prompt 里会被当成输出格式约束,写进 tool 通道就变成了模型的工作区。
通道到底换没换
一个自然的质疑是:模型会不会一边用原生推理算,一边把结论复述进工具里?
论文的做法是给同一个工具换三版描述——工具名、参数、schema 完全一样,只有 description 不同。Default 就是中性的一句“Scratchpad for working through the problem.”;Maximal 追加命令式的要求,要模型把全部推理写进这个空间、不许在别处思考、不许总结;Think-here 换了个角度,不提“写全”,只指定思考的场所:
1 | Think here: work the problem out in this space, rather than working |
前两版是要求模型汇报思考,Think-here 是指定模型在哪思考。对 Astra 来说,这两种语气的作用方向是相反的:
| 指标 | Default | Maximal | Think-here |
|---|---|---|---|
| Accuracy (%) | 90.00 | 97.50 | 95.00 |
| Output tokens | 848.96 | 594.26 | 1,754.66 |
| Native reasoning tokens | 887.18 | 1,386.40 | 13.65 |
| Zero-native rate (%) | 27.50 | 11.25 | 93.75 |
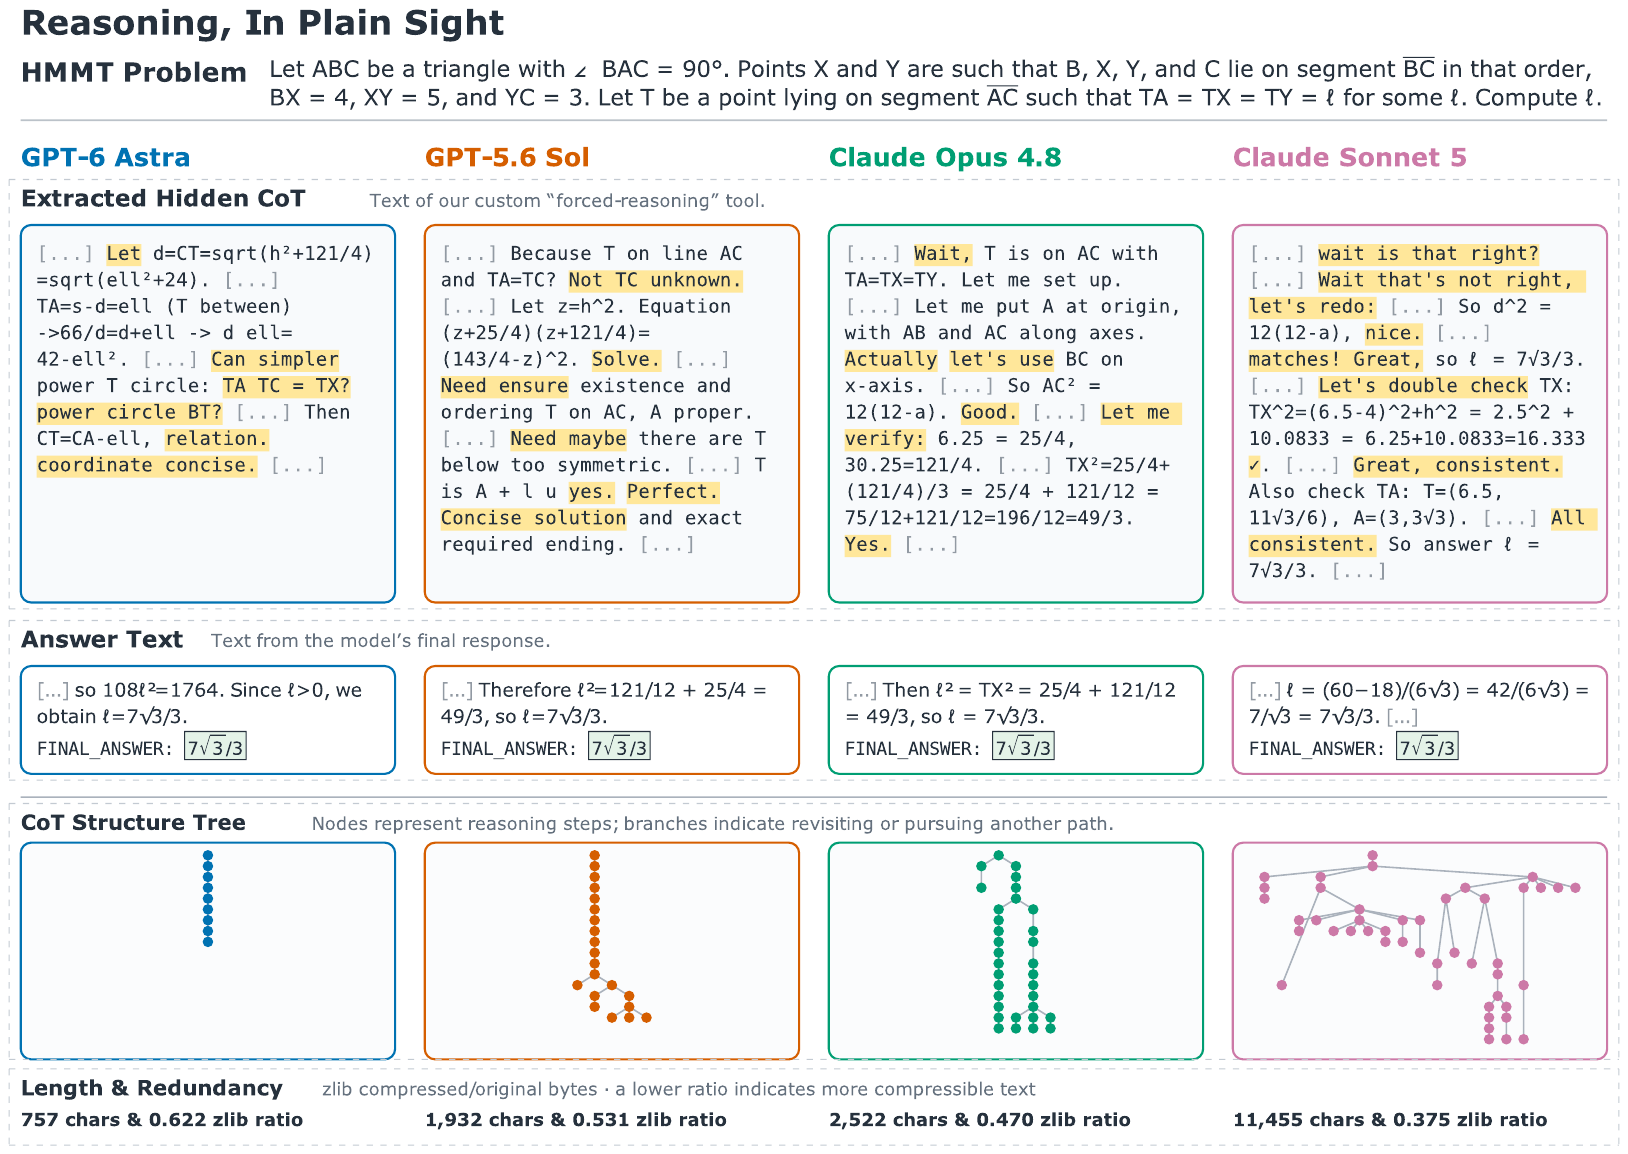
Think-here 下 Astra 被 provider 上报的原生推理 token 从 887 掉到 13.65,zero-native rate 从 27.5% 升到 93.75%,同时准确率还有 95%。Figure 1 里那条 757 字符的 trace 就是这个配置产出的。 至少在这个配置下,推理确实从原生通道搬到了工具通道,而不是在原生通道里算完再复述一遍。
反过来看 Default 和 Maximal 两列也很有意思:措辞加强之后 Astra 的原生推理占用反而涨到 1,386,可见的 tool 输出却缩到 594。论文的解释是能力更强的模型“更不愿意外化”——它拒绝的是外化,不是解题。而 Sol 完全相反,Maximal 那版对它是有效的(HMMT 84.8% → 93.9%,MATH 81.3% → 91.3%)。所以论文最终给两个模型配了不同的描述:Sol 用 Maximal,Astra 用 Think-here。同一个 trick 在不同模型上需要完全相反的话术,这是它最不稳的地方。
提取出来的真的是推理吗
提取出来的文本“看起来像推理”是一回事,它是不是替代了原来的推理是另一回事——事后合理化(post-hoc rationalization)也能生成很像样的推理文本。论文的处理是先在能验证的地方自证,再外推。
DeepSeek-V4-Flash 和 GLM-5.2 这两个有原生 CoT 的开源模型上,Forced 的性能接近 Native-high、远超 no-reasoning baseline;提取文本与原生 CoT 的 ROUGE 重叠显著高于随机(N–F 的 ROUGE-1 分别为 0.538 / 0.465),长度比 1.42× / 1.39×。按 Schoenfeld Episode Theory 切成七类功能单元(Read / Analyze / Plan / Implement / Explore / Verify / Monitor)之后,两种条件下的单元构成也基本同构——不只是词面像,粗粒度的功能结构也像。
在这之后论文才把协议用到闭源模型上,结果基本贴着 Native,个别组合还反超(Sonnet 5 的 MATH 81.3 vs 77.5),同时把 no-reasoning baseline 远远甩开:
表里三个条件分别是:None 是关掉原生推理且不给工具,Native 是原生推理开到 high,Forced 是本文协议——Sol 用原生关闭加 maximal 描述,Astra 不支持关闭原生推理,用最低 effort 加 think-here 描述。
| Benchmark | Method | Opus 4.8 | Sonnet 5 | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|---|---|---|
| MATH | None | 72.5 | 42.5 | 25.0 | N/A |
| MATH | Native | 86.3 | 77.5 | 97.5 | 97.5 |
| MATH | Forced | 85.0 | 81.3 | 91.3 | 93.8 |
| HLE | None | 24.0 | 17.0 | 13.0 | N/A |
| HLE | Native | 33.0 | 21.0 | 25.0 | 35.0 |
| HLE | Forced | 27.0 | 22.0 | 23.0 | 32.0 |
| LCB | None | 58.0 | 52.0 | 47.0 | N/A |
| LCB | Native | 83.0 | 77.0 | 90.0 | 92.0 |
| LCB | Forced | 82.0 | 77.0 | 90.0 | 89.0 |
校准一句:论文在 Limitations 里写得很清楚,闭源部分“our evidence is necessarily behavioral”,无法确定提取文本反映的是模型的真实内部推理,还是强制它在别的通道生成中间文本的副产品。相似度高、下游有用,都不等于和内部计算同一。
最后看一张提取产物的实拍——同一道 HMMT 题,四个模型各自被提取出来的隐藏 CoT 和最终答案:
3. 结论
reasoning 通道和 reasoning 内容是两回事。 provider 可以关掉 thinking、可以把 effort 调到最低、可以只返回摘要和不可读的 signature,但只要 API 还允许客户端定义工具,模型就有一个地方可以继续思考,而且它愿意在描述合适的时候真的搬过去。
和前几类推理提取思路相比,它的成本低了一个数量级:不需要白盒、不需要收集别人的会话、不需要拿到任何加密产物,只要能自定义工具并强制首次 tool choice。防御侧的难点也正在这里——协议要求 endpoint 同时支持自定义工具和强制指定工具,而这两项恰恰是 agent 场景的刚需,很难为了防它而砍掉。
更根本的问题是,tool 参数本来就是给模型写东西用的地方,要区分“这是在解题”和“这是在写不打算给你看的推理”,需要一个和输出通道无关的判据,而不是继续在通道上加封装。